ถามจากเอกสารยาว: วางคำถามไว้ตรงไหนให้ AI ตอบถูก ทดลองจริงใน 30 นาที
สคริปต์ถามคำถามจากเอกสารยาวที่เอาไปใช้กับไฟล์ของคุณเองได้ทันที + กติกา 1 ข้อเรื่องลำดับข้อมูลกับคำถามที่คุณเห็นผลด้วยตาตัวเองว่าทำให้โมเดลเล็กจากตอบ "ไม่พบ" กลายเป็นตอบถูก และทำให้ค่าใช้จ่ายต่อคำถามลดลง 10 เท่า
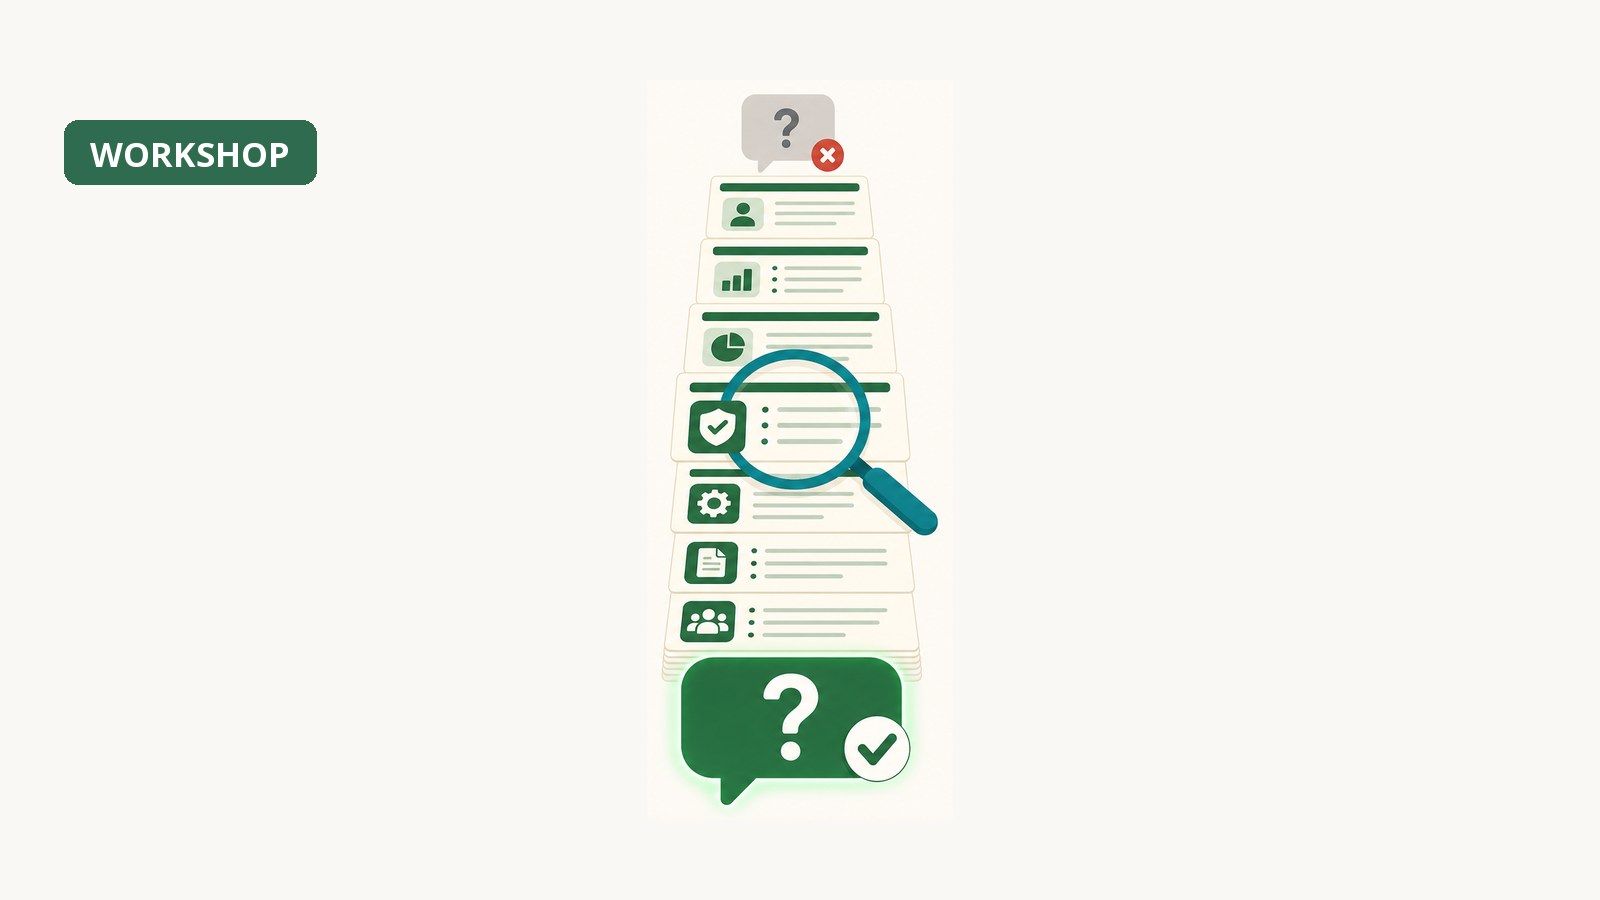
ใน workshop เทียบโมเดล เราส่งข้อความลูกค้าสั้น ๆ ก้อนเดียว วันนี้เปลี่ยนเป็นของจริงที่ทุกคนอยากทำ: โยนเอกสารยาวเป็นสิบ ๆ หน้าให้ Claude แล้วถามคำถามที่คำตอบซ่อนอยู่กลางเอกสาร เราจะเขียนสคริปต์ที่ถามได้ทีละหลายคำถาม พร้อมพิมพ์ค่าใช้จ่ายและตัวเลข cache ออกมาทุกครั้ง แล้วทำการทดลองที่ตอบคำถามเดียว: เอาคำถามไว้ก่อนเอกสาร หรือไว้หลังเอกสาร มันต่างกันจริงไหม ผลที่เห็นกับตาคือรุ่นเล็กสุดตอบว่า “ไม่พบ” ทั้งที่ข้อมูลอยู่ในเอกสาร แล้วสลับบรรทัดเดียวก็ตอบถูก และค่าใช้จ่ายต่อคำถามที่ลดลง 10 เท่ามาเป็นของแถม ถ้ายังไม่แน่ใจว่าโทเคนกับ context window คืออะไร แวะอ่านRAG ทำงานอย่างไรก่อนได้ workshop นี้ใช้แค่ความรู้ว่า “โมเดลอ่านได้จำกัดและคิดเงินตามที่อ่าน”
ขั้นที่ 1: โหลดเอกสารยาว แล้วนับโทเคนแบบไม่เสียเงิน
เพื่อให้คุณทำตามแล้วเห็นผลตรงกับในบทความ เราเตรียมเอกสารทดลองไว้ให้: บทความ 12 ชิ้นจากเว็บนี้ต่อกันเป็นไฟล์เดียว ยาวเกือบแสนตัวอักษร (ใช้ทดลองส่วนตัวได้ ไม่ต้องขอ) ดาวน์โหลดลงโฟลเดอร์เดียวกับ bakeoff.py ของ workshop ก่อน
บน Mac หรือ Linux:
curl -o docs.md https://aiitpulse.com/workshops/long-document-question-placement/docs.mdบน Windows ให้พิมพ์ curl.exe (มีจุด exe) แทน curl ใน PowerShell หรือจะเปิดลิงก์ในเบราว์เซอร์แล้ว Save As เป็น docs.md ก็ได้ผลเดียวกัน
curl จะโชว์แถบความคืบหน้าสั้น ๆ แล้วจบ เช็กว่าได้ไฟล์ครบด้วยการดูขนาด (Windows ใช้ dir docs.md):
ls -l docs.md-rw-r--r-- 1 username staff 240332 Sep 16 16:07 docs.mdต้องได้ราว 240,332 ไบต์ ถ้าได้ไฟล์เล็กกว่านี้มาก (เช่นไม่กี่ร้อยไบต์) แปลว่าโหลดมาผิด ให้เปิดลิงก์ในเบราว์เซอร์แล้วดูว่าขึ้นเป็นข้อความบทความภาษาไทยไหม
ก่อนส่งอะไรที่ยาวขนาดนี้ไปให้โมเดล ควรรู้ก่อนว่ามันกี่โทเคน เพราะบิลคิดตามโทเคน ไม่ใช่ตามตัวอักษร และภาษาไทยกินโทเคนต่อตัวอักษรไม่เหมือนอังกฤษ API มี endpoint นับโทเคนให้ฟรี สร้างไฟล์ count_doc.py:
import anthropic

doc = open("docs.md", encoding="utf-8").read()
client = anthropic.Anthropic()
count = client.messages.count_tokens(
    model="claude-haiku-4-5",
    messages=[{"role": "user", "content": doc}],
)
print(f"ตัวอักษร {len(doc):,} · โทเคน {count.input_tokens:,}")
python3 count_doc.pyตัวอักษร 96,984 · โทเคน 76,28776,000 โทเคนคือราว 38% ของ context window 200,000 ของ Haiku 4.5 ใหญ่พอที่จะเห็นอาการของ “context ยาว” แต่ยังไม่ชนเพดาน และทุกคำถามที่เราจะถามต่อจากนี้ต้องส่ง 76,000 โทเคนนี้ไปใหม่ทุกครั้ง จำตัวเลขนี้ไว้ มันจะกลับมาในขั้นที่ 4
มีไฟล์
docs.mdในโฟลเดอร์ และcount_doc.pyพิมพ์เลขโทเคนราว 76,000 (บวกลบไม่กี่ร้อย) = ผ่าน ไปจดคำตอบที่ถูกกันก่อน
ขั้นที่ 2: จดคำตอบที่ถูก และตำแหน่งของมัน ไว้ก่อนรัน
เหมือน workshop ก่อน ถ้าไม่จดคำตอบไว้ก่อน คุณจะเผลอเชื่อคำตอบที่เขียนสวย ๆ เราเลือกคำถาม 3 ข้อที่ตอบได้จากประโยคเดียวในเอกสาร และจงใจเลือกเฉพาะข้อที่คำตอบอยู่ เอกสารที่ 5 ถึง 8 จาก 12 คือกลางไฟล์พอดี เพราะงานวิจัยชื่อ Lost in the Middle (Liu และคณะ, 2023) พบว่าโมเดลอ่านต้นกับท้าย context ได้ดีกว่าตรงกลาง เราอยากรู้ว่าปี 2026 อาการนี้ยังอยู่ไหม
- ข้อ 1 — ราคาเก็บข้อมูล on-demand ของ Snowflake กี่ดอลลาร์ต่อ TB ต่อเดือน และข้อมูลดิบ 30 TB เหลือคิดเงินกี่ TB คำตอบ: 23 ดอลลาร์ และ ราว 10 TB อยู่เอกสารที่ 7
- ข้อ 2 — tutorial ส่วนใหญ่สอนให้ตัด chunk ทุกกี่ตัวอักษร และแนะนำไลบรารีตัดคำไทยตัวไหน คำตอบ: 500 ตัวอักษร และ PyThaiNLP อยู่เอกสารที่ 5
- ข้อ 3 — agent ที่สำเร็จ 75% ต่อรอบ ถ้าวัดแบบ pass^3 เหลือกี่เปอร์เซ็นต์ และความล้มเหลวของ agent ใน production ส่วนใหญ่เป็นปัญหาเชิงอะไร คำตอบ: ราว 42% และ เชิงสถาปัตยกรรม อยู่เอกสารที่ 8
เกณฑ์ตัดสินมีข้อเดียว: คำตอบต้องมีตัวเลขหรือคำที่จดไว้ครบ และห้ามขึ้นต้นว่า “ไม่พบ” เพราะเราจะสั่งโมเดลชัด ๆ ว่าถ้าไม่มีในเอกสารให้ตอบว่าไม่พบ ดังนั้นการตอบว่าไม่พบทั้งที่มี คือความผิดพลาดแบบที่โปรแกรมของคุณจะเชื่อและทำงานต่อผิด ๆ ทันที
มีคำถาม 3 ข้อ คำตอบ 3 ชุด และรู้ว่าทุกข้ออยู่กลางไฟล์ = ผ่าน ไปเขียนสคริปต์
ขั้นที่ 3: สคริปต์ถามเอกสาร แบบวางคำถามไว้ก่อนเอกสาร
สร้างไฟล์ askdoc.py วางทั้งก้อน โครงเหมือน bakeoff.py แต่คราวนี้ข้อความที่ส่งไม่ใช่ string เดียว เป็น list ของก้อนข้อความ 2 ก้อน คือก้อนเอกสารกับก้อนคำถาม แล้วมีตัวแปร ORDER ตัวเดียวกำหนดว่าก้อนไหนมาก่อน:
import time
import anthropic

MODEL = "claude-haiku-4-5"
ORDER = "question_first"   # ขั้นที่ 4 เปลี่ยนเป็น "document_first"

# ราคาต่อ 1 ล้านโทเคน (ขาเข้า, ขาออก) หน่วยดอลลาร์ ตรวจล่าสุด 2026-09-16
PRICES = {"claude-haiku-4-5": (1.00, 5.00), "claude-sonnet-5": (2.00, 10.00)}
THB_PER_USD = 36

DOC = open("docs.md", encoding="utf-8").read()
INSTRUCTION = "ตอบคำถามต่อไปนี้จากเอกสารที่ให้มาเท่านั้น ตอบสั้น ๆ ตรงประเด็น ถ้าเอกสารไม่ได้บอกให้ตอบว่าไม่พบ"
QUESTIONS = [
    "ตามเอกสาร ราคาเก็บข้อมูลแบบ on-demand ของ Snowflake อยู่ที่ราวกี่ดอลลาร์ต่อ TB ต่อเดือน และข้อมูลดิบ 30 TB จะเหลือที่คิดเงินจริงราวกี่ TB",
    "เอกสารบอกว่า tutorial ส่วนใหญ่สอนให้ตัด chunk ทุก ๆ กี่ตัวอักษร และแนะนำไลบรารีตัดคำภาษาไทยตัวไหน",
    "เอกสารยกตัวอย่างของ Anthropic เรื่อง agent ที่สำเร็จ 75% ต่อรอบ ถ้าวัดแบบ pass^3 โอกาสสำเร็จเหลือประมาณกี่เปอร์เซ็นต์ และเอกสารสรุปว่าความล้มเหลวของ agent ใน production ส่วนใหญ่เป็นปัญหาเชิงอะไร",
]

client = anthropic.Anthropic()
price_in, price_out = PRICES[MODEL]

for question in QUESTIONS:
    doc_block = {"type": "text", "text": "<เอกสาร>\n" + DOC + "\n</เอกสาร>", "cache_control": {"type": "ephemeral"}}
    question_block = {"type": "text", "text": f"{INSTRUCTION}\n\nคำถาม: {question}"}
    content = [question_block, doc_block] if ORDER == "question_first" else [doc_block, question_block]

    start = time.time()
    response = client.messages.create(
        model=MODEL,
        max_tokens=2000,
        messages=[{"role": "user", "content": content}],
    )
    seconds = time.time() - start
    answer = "".join(block.text for block in response.content if block.type == "text")
    u = response.usage
    cache_write = u.cache_creation_input_tokens or 0
    cache_read = u.cache_read_input_tokens or 0
    cost_usd = (u.input_tokens * price_in + cache_write * price_in * 1.25
                + cache_read * price_in * 0.10 + u.output_tokens * price_out) / 1_000_000
    print(f"=== {MODEL} · {ORDER} · {seconds:.1f} วินาที · {cost_usd * THB_PER_USD:.2f} บาท")
    print(f"    ขาเข้าปกติ {u.input_tokens:,} · เขียน cache {cache_write:,} · อ่านจาก cache {cache_read:,} · ขาออก {u.output_tokens}")
    print(f"ถาม: {question}")
    print(answer)
    print()
สามจุดที่ต่างจาก bakeoff.py และควรรู้ว่าทำไม:
- ก้อนเอกสารครอบด้วยแท็ก
<เอกสาร>— ให้โมเดลรู้ขอบเขตชัดว่าตรงไหนคือข้อมูล ตรงไหนคือคำสั่ง Anthropic แนะนำให้ใช้แท็กแบบนี้กับเนื้อหายาวเสมอ - บรรทัด
cache_control— บอก API ว่าก้อนนี้ขอเก็บไว้ใช้ซ้ำ ตอนนี้ยังไม่ต้องเข้าใจ แค่ให้มันอยู่ตรงนั้น ขั้นที่ 4 จะเห็นเองว่ามันทำอะไร - บรรทัด
cost_usd— คิดเงิน 4 ส่วนแยกกัน เพราะโทเคนที่เขียนลง cache แพงกว่าปกติ 25% แต่โทเคนที่อ่านจาก cache ถูกกว่าปกติ 90% สคริปต์จึงพิมพ์ทั้ง 4 ตัวเลขให้ดูทุกครั้ง
ตอนนี้ ORDER เป็น question_first คือคำสั่งกับคำถามมาก่อน แล้วเอกสารตามหลัง ซึ่งเป็นลำดับที่คนส่วนใหญ่เขียนโดยธรรมชาติ (“ช่วยตอบคำถามนี้จากเอกสารข้างล่าง”) รันได้เลย ใช้เวลาราว 20 วินาที:
python3 askdoc.py=== claude-haiku-4-5 · question_first · 6.5 วินาที · 3.52 บาท
ขาเข้าปกติ 3 · เขียน cache 76,512 · อ่านจาก cache 0 · ขาออก 447
ถาม: ตามเอกสาร ราคาเก็บข้อมูลแบบ on-demand ของ Snowflake อยู่ที่ราวกี่ดอลลาร์ต่อ TB ต่อเดือน และข้อมูลดิบ 30 TB จะเหลือที่คิดเงินจริงราวกี่ TB
ขออภัย ฉันไม่พบข้อมูลที่ตรงกับคำถามของคุณในเอกสารที่ให้มา
เอกสารที่ 3 (Snowflake Architecture) อธิบายเกี่ยวกับสถาปัตยกรรมสามชั้นของ Snowflake แต่ **ไม่ได้ระบุรายละเอียดเกี่ยวกับราคาเก็บข้อมูลแบบ on-demand** หรือ **การคำนวณจำนวน TB ที่คิดเงินจริง**
เอกสารกล่าวถึง:
- "ราวกี่ดอลลาร์ต่อ TB ต่อเดือน" แค่ในบริบททั่วไปว่ามี storage layer
- การบีบอัดข้อมูลอัตโนมัติ แต่ไม่ได้ให้ตัวเลขชี้เจาะจงแค่ไหน
**เพื่อให้คำตอบที่แม่นยำ** ฉันจำเป็นต้องมีเอกสารที่ระบุราคา Snowflake หรือตัวอย่างการคำนวณค่าเก็บข้อมูลอย่างชัดเจน ซึ่งไม่มีอยู่ในเอกสารที่ให้มา
=== claude-haiku-4-5 · question_first · 6.0 วินาที · 3.51 บาท
ขาเข้าปกติ 3 · เขียน cache 76,482 · อ่านจาก cache 0 · ขาออก 373
ถาม: เอกสารบอกว่า tutorial ส่วนใหญ่สอนให้ตัด chunk ทุก ๆ กี่ตัวอักษร และแนะนำไลบรารีตัดคำภาษาไทยตัวไหน
# ตอบคำถาม
จากเอกสารที่ให้มา:
**Tutorial ส่วนใหญ่สอนให้ตัด chunk ทุก ๆ 500 ตัวอักษร**
และ**แนะนำไลบรารีตัดคำภาษาไทยตัว [PyThaiNLP](https://github.com/PyThaiNLP/pythainlp)**
...
=== claude-haiku-4-5 · question_first · 7.6 วินาที · 3.53 บาท
ขาเข้าปกติ 3 · เขียน cache 76,554 · อ่านจาก cache 0 · ขาออก 468
ถาม: เอกสารยกตัวอย่างของ Anthropic เรื่อง agent ที่สำเร็จ 75% ต่อรอบ ...
# คำตอบ
จากเอกสารที่ให้มา:
## คำตอบสำหรับการวัดแบบ pass^3
เอกสารยกตัวอย่าง **agent ที่สำเร็จ 75% ต่อรอบ**
เมื่อวัดแบบ pass^3 (ต้องทำสำเร็จ 3 รอบติดต่อกัน):
- 0.75³ ≈ **42%**
...ดูข้อ 1 ให้ดี: โมเดลบอกว่า “ไม่พบข้อมูลที่ตรงกับคำถาม” แล้วอธิบายต่ออย่างมั่นใจว่าเอกสารพูดถึงราคาแค่ “ในบริบททั่วไป” ทั้งที่ประโยค “ราว 23 ดอลลาร์ต่อ TB ต่อเดือน” กับ “30 TB จึงอาจเหลือที่คิดเงินจริงราว 10 TB” อยู่ในเอกสารที่ 7 แบบตรงตัว มันยังอ้างเลขเอกสารผิดด้วย (บอกเอกสารที่ 3) ส่วนข้อ 2 กับ 3 รอบนี้ตอบถูก แต่มาพร้อมหัวข้อ # และย่อหน้าเกริ่นยาว ๆ จนขาออกอยู่ที่ 370-470 โทเคน
รอบเดียวยังสรุปไม่ได้ ตอนเตรียม workshop นี้เรารันชุดคำถาม 6 ข้อกับ Haiku แบบคำถามก่อนอีก 2 รอบเต็ม รอบแรกตอบว่าไม่พบ 3 ใน 6 ข้อ รอบสองตอบว่าไม่พบ 5 ใน 6 ข้อ และเคสที่น่าขนลุกที่สุดคือหลายครั้งมันขึ้นต้นว่า “ไม่พบ” แล้วอีก 3 บรรทัดถัดมาก็ยกประโยคที่มีคำตอบครบถ้วนจากเอกสารมาอ้างเอง คนอ่านงง แต่โปรแกรมที่รับคำตอบไปใช้ต่อจะเห็นแค่คำว่า “ไม่พบ” บรรทัดแรกแล้วเดินต่อผิดทางเงียบ ๆ
อีกอย่างที่อยากให้สังเกตคือบรรทัด usage: ขาเข้าปกติ 3 · เขียน cache 76,512 · อ่านจาก cache 0 ทั้ง 3 ข้อ แปลว่าเราจ่ายค่าเขียน cache แพงกว่าปกติ 25% ทุกครั้ง แต่ไม่เคยได้อ่านคืนเลยสักครั้ง คำถามละ 3.5 บาท เก็บตัวเลขนี้ไว้เทียบ
รันผ่านทั้ง 3 ข้อ และเห็นอย่างน้อย 1 ข้อที่โมเดลตอบว่า “ไม่พบ” ทั้งที่คุณจดคำตอบไว้ว่ามี = ผ่าน (ถ้าถูกหมดทั้ง 3 ข้อ ดูกล่องท้ายเรื่อง) ไปสลับลำดับ
ขั้นที่ 4: สลับบรรทัดเดียว แล้วรันใหม่
แก้บรรทัดเดียวในไฟล์ จาก ORDER = "question_first" เป็น:
ORDER = "document_first" # เอกสารก่อน คำถามท้ายสุดไม่ต้องแก้อย่างอื่น คำสั่ง คำถาม เอกสาร โมเดล เหมือนเดิมทุกตัวอักษร แค่ก้อนเอกสารมาก่อนก้อนคำถาม รันใหม่:
python3 askdoc.py=== claude-haiku-4-5 · document_first · 3.5 วินาที · 3.48 บาท
ขาเข้าปกติ 213 · เขียน cache 76,302 · อ่านจาก cache 0 · ขาออก 203
ถาม: ตามเอกสาร ราคาเก็บข้อมูลแบบ on-demand ของ Snowflake อยู่ที่ราวกี่ดอลลาร์ต่อ TB ต่อเดือน และข้อมูลดิบ 30 TB จะเหลือที่คิดเงินจริงราวกี่ TB
ตามเอกสาร (เอกสารที่ 3: Micro-partition):
- ราคาเก็บข้อมูลแบบ on-demand ของ Snowflake อยู่ที่ราว **23 ดอลลาร์ต่อ TB ต่อเดือน**
- เพราะ Snowflake บีบอัดข้อมูลให้อัตโนมัติราว **3 ต่อ 1** ในงานทั่วไป
- ข้อมูลดิบ 30 TB จึงอาจเหลือที่คิดเงินจริงราว **10 TB** เท่านั้น
=== claude-haiku-4-5 · document_first · 3.3 วินาที · 0.33 บาท
ขาเข้าปกติ 183 · เขียน cache 0 · อ่านจาก cache 76,302 · ขาออก 265
ถาม: เอกสารบอกว่า tutorial ส่วนใหญ่สอนให้ตัด chunk ทุก ๆ กี่ตัวอักษร และแนะนำไลบรารีตัดคำภาษาไทยตัวไหน
จากเอกสารที่ให้มา:
**ตัด chunk ทุก ๆ 500 ตัวอักษร** - นี่คือวิธีที่ tutorial ส่วนใหญ่สอน แต่เอกสารชี้ว่าใช้ได้กับภาษาอังกฤษ ไม่เหมาะกับภาษาไทย
**ไลบรารีตัดคำภาษาไทยที่แนะนำคือ PyThaiNLP** - เอกสารระบุว่าเป็นตัวเลือกที่ปลอดภัยกว่าในการตัด chunk สำหรับภาษาไทย
(ข้อมูลนี้อยู่ในเอกสารที่ 5: เตรียมเอกสารก่อนทำ RAG)
=== claude-haiku-4-5 · document_first · 4.5 วินาที · 0.34 บาท
ขาเข้าปกติ 255 · เขียน cache 0 · อ่านจาก cache 76,302 · ขาออก 332
ถาม: เอกสารยกตัวอย่างของ Anthropic เรื่อง agent ที่สำเร็จ 75% ต่อรอบ ...
จากเอกสารที่ 8 (AI Agent ทำงานยังไง):
**โอกาสสำเร็จแบบ pass^3:**
0.75³ ≈ **42%** (ลดลงจากเดิม 75%)
**ความล้มเหลวของ agent ใน production ส่วนใหญ่เป็นปัญหาเชิงอะไร:**
**สถาปัตยกรรม** (ไม่ใช่คุณภาพของโมเดล)
...ถูกครบ 3 ข้อ ข้อ 1 ที่เมื่อกี้ “ไม่พบ” ตอนนี้ตอบ 23 ดอลลาร์กับ 10 TB ตรงตัว (ยังอ้างเลขเอกสารผิดอยู่ ดูกล่องท้ายเรื่อง) คำตอบสั้นลงครึ่งหนึ่ง เวลาตอบสั้นลงครึ่งหนึ่ง และไม่มีย่อหน้าเกริ่น ในการรัน 2 รอบเต็มที่พูดถึงเมื่อกี้ ลำดับนี้ทำให้ Haiku ตอบถูก 6 ใน 6 ข้อทั้งสองรอบ
ทำไมถึงต่างขนาดนี้ Anthropic เขียนไว้ตรง ๆ ในคู่มือเรื่อง long context: วางเอกสารไว้บนสุด แล้ววางคำถามไว้ท้ายสุดของ prompt และรายงานว่าในเทสของเขาวิธีนี้ทำให้คุณภาพคำตอบดีขึ้นได้ถึง 30% เมื่อ context ยาวหรือมีหลายเอกสาร เหตุผลแบบเข้าใจง่ายคือโมเดลอ่านจากบนลงล่างและสร้างคำตอบต่อจากสิ่งที่อ่านล่าสุด ถ้าคำถามอยู่บนสุด พออ่านเอกสาร 76,000 โทเคนจบ คำถามก็อยู่ไกลที่สุดจากจุดที่มันเริ่มตอบ รุ่นใหญ่รับมือได้ รุ่นเล็กเริ่มหลุด
กล่องข้าง: ทำไมข้อ 2 กับ 3 ราคาตกจาก 3.5 บาท เหลือ 0.33 บาท ดูบรรทัด usage อีกที รอบนี้ข้อ 1 เขียน cache 76,302 แล้วข้อ 2 กับ 3 อ่านจาก cache 76,302 ทั้งคู่ ส่วนขั้นที่ 3 ไม่มีการอ่านเลย ทั้งที่บรรทัด cache_control เหมือนกันเป๊ะ เพราะ cache ของ API ทำงานแบบ “จำจากหัว prompt ลงมา” มันจะใช้ซ้ำได้ก็ต่อเมื่อส่วนต้นของ prompt เหมือนเดิมทุกตัวอักษร พอเอกสารอยู่ก่อน หัว prompt คือเอกสารก้อนเดิมทุกครั้ง cache จึงใช้ได้ พอคำถามอยู่ก่อน หัว prompt เปลี่ยนทุกคำถาม cache จึงไม่เคยใช้ได้เลย นี่คือเหตุผลที่ลำดับ “ข้อมูลก่อน คำถามท้าย” ไม่ใช่แค่เรื่องความถูกต้อง แต่เป็นเรื่องบิลด้วย ถ้าวันหนึ่งคุณถามเอกสารเดิม 100 คำถาม ต่างกันคือ 350 บาทกับ 36 บาท ส่วนกติกาละเอียดของ cache (ขั้นต่ำกี่โทเคนถึงจะ cache ได้ อยู่ได้นานแค่ไหน วางจุด cache หลายจุดยังไง) เป็นเรื่องของบทที่ 5 ในเล่มท้ายเรื่อง
ทั้ง 3 ข้อตอบถูกตามที่จดไว้ และเห็นบรรทัด “อ่านจาก cache 76,xxx” ในข้อ 2 กับ 3 = ผ่าน ไปเทียบรุ่นกลาง
ขั้นที่ 5: ลองรุ่นกลางในลำดับผิด แล้วจดกติกาไว้ในโค้ด 1 บรรทัด
คำถามที่ควรถามต่อคือ “ถ้าใช้รุ่นใหญ่ขึ้น ปัญหานี้หายไปเองไหม” ทดลองได้ในราคาราว 22 บาท แก้ 2 บรรทัดบนสุด:
MODEL = "claude-sonnet-5"
ORDER = "question_first"   # กลับไปลำดับผิด แต่เปลี่ยนเป็นรุ่นกลาง
python3 askdoc.py=== claude-sonnet-5 · question_first · 4.4 วินาที · 7.20 บาท
ขาเข้าปกติ 2 · เขียน cache 79,291 · อ่านจาก cache 0 · ขาออก 186
ถาม: ตามเอกสาร ราคาเก็บข้อมูลแบบ on-demand ของ Snowflake อยู่ที่ราวกี่ดอลลาร์ต่อ TB ต่อเดือน และข้อมูลดิบ 30 TB จะเหลือที่คิดเงินจริงราวกี่ TB
ตามเอกสารที่ 7 (Micro-partition): ราคาเก็บข้อมูลแบบ on-demand ของ Snowflake อยู่ที่ราว **23 ดอลลาร์ต่อ TB ต่อเดือน** (เรต AWS US East) และเพราะ Snowflake บีบอัดข้อมูลอัตโนมัติราว 3 ต่อ 1 ข้อมูลดิบ 30 TB จะเหลือที่คิดเงินจริงราว **10 TB**
=== claude-sonnet-5 · question_first · 2.9 วินาที · 7.17 บาท
ขาเข้าปกติ 2 · เขียน cache 79,261 · อ่านจาก cache 0 · ขาออก 96
ถาม: เอกสารบอกว่า tutorial ส่วนใหญ่สอนให้ตัด chunk ทุก ๆ กี่ตัวอักษร และแนะนำไลบรารีตัดคำภาษาไทยตัวไหน
ตาม เอกสารที่ 5 tutorial ส่วนใหญ่สอนให้ตัด chunk ทุก ๆ 500 ตัวอักษร และแนะนำไลบรารีตัดคำภาษาไทย **PyThaiNLP**
=== claude-sonnet-5 · question_first · 4.9 วินาที · 7.23 บาท
ขาเข้าปกติ 2 · เขียน cache 79,333 · อ่านจาก cache 0 · ขาออก 246
ถาม: เอกสารยกตัวอย่างของ Anthropic เรื่อง agent ที่สำเร็จ 75% ต่อรอบ ...
ตามเอกสารที่ 8:
- **Pass^3 ของ agent ที่สำเร็จ 75% ต่อรอบ**: เหลือประมาณ **42%** (0.75³ ≈ 42%)
- **สรุปสาเหตุความล้มเหลวของ agent ใน production**: ส่วนใหญ่เป็น**ปัญหาเชิงสถาปัตยกรรม** ...Sonnet 5 ตอบถูกครบ อ้างเลขเอกสารถูกทุกข้อ และตอบสั้นกว่า Haiku ด้วยซ้ำ ในการรัน 2 รอบเต็มของเรา Sonnet ถูก 6 ใน 6 ทั้งสองลำดับ รุ่นใหญ่ขึ้นจึงกลบปัญหาความถูกต้องได้จริง แต่ดูบรรทัดค่าใช้จ่าย: คำถามละ 7.2 บาท และ “อ่านจาก cache 0” ทั้ง 3 ข้อ เพราะลำดับผิดทำให้ cache ไม่ทำงานเหมือนเดิม เทียบกับ Haiku ลำดับถูกที่ 0.33 บาทต่อคำถาม ต่างกัน 22 เท่าบนคำถามชุดเดียวกัน (โทเคนของ Sonnet นับได้ 79,000 จากเอกสารเดียวกัน เพราะแต่ละรุ่นตัดโทเคนไม่เหมือนกัน นี่ก็เป็นอีกเหตุผลที่ต้องนับด้วย API ไม่ใช่นับตัวอักษร)
กติกาที่ได้จากวันนี้จึงมีข้อเดียวและใช้กับทุกรุ่น: ข้อมูลก่อน คำถามท้ายสุด สำหรับรุ่นเล็กมันคือเส้นแบ่งระหว่างตอบถูกกับตอบว่าไม่พบ สำหรับรุ่นกลางขึ้นไปมันคือเส้นแบ่งระหว่างจ่ายเต็มกับจ่าย 10% แล้วจดไว้ในไฟล์ให้ตัวเองในอนาคตอ่านเจอ:
# กติกา (2026-09-16): เอกสารก่อน คำถามท้ายสุด เสมอ: haiku ลำดับกลับตอบ "ไม่พบ" 3/6 และ 5/6 ข้อทั้งที่มี, ลำดับถูก 6/6; cache อ่านคืนได้เฉพาะลำดับถูก (0.33 vs 3.5 บาท/คำถาม)หมายเหตุสำหรับคนที่ทำ workshop เทียบโมเดลมาแล้ว: bakeoff.py วางคำสั่งก่อนข้อความลูกค้า ซึ่งกับข้อความไม่กี่ร้อยโทเคนเราเทสแล้วว่าไม่มีผล (Haiku ผิดเรื่อง “โหลครึ่ง” ทั้งสองลำดับ) กติกานี้เริ่มมีน้ำหนักเมื่อข้อมูลยาวเป็นหมื่นโทเคน แต่ติดเป็นนิสัยไว้ตั้งแต่สคริปต์เล็กก็ไม่เสียหาย
มีบรรทัดกติกาอยู่ในไฟล์ พร้อมสคริปต์ที่เปลี่ยน
docs.mdเป็นไฟล์ของคุณเองได้ทันที = ผ่านครบทุกด่าน จบ workshop
ไปต่อจากตรงนี้
วันนี้คุณได้สคริปต์ที่ถามอะไรก็ได้จากเอกสารยาวเป็นสิบ ๆ หน้าโดยรู้ค่าใช้จ่ายทุกคำถาม ได้เห็นด้วยตาว่า lost-in-the-middle ยังเป็นเรื่องจริงในปี 2026 สำหรับรุ่นเล็ก และได้กติกาลำดับที่แก้ทั้งความถูกต้องและบิลในบรรทัดเดียว ลองเปลี่ยน docs.md เป็นคู่มือพนักงาน สัญญา หรือรายงานของคุณเอง แล้วถามคำถามที่คุณรู้คำตอบอยู่แล้วสัก 3 ข้อ นั่นคือการเทสที่ตรงกับงานจริงที่สุด
สิ่งที่วิธีนี้ยังทำไม่ได้คือเอกสารที่ใหญ่กว่า context window หรือกองเอกสารหลายร้อยไฟล์ที่ส่งไปทั้งหมดทุกคำถามไม่ไหวทั้งเรื่องเงินและเวลา ทางออกคือค้นเฉพาะส่วนที่เกี่ยวมาส่งให้โมเดล ซึ่งคือ RAG อ่านภาพรวมได้ที่RAG ทำงานอย่างไร และเรื่องที่คนเจอก่อนเสมอคือเตรียมเอกสารก่อนทำ RAG ส่วนการต่อจากสคริปต์วันนี้ไปเป็นระบบถามตอบจริง ทั้งโครง prompt ทั้งชุด ต้นทุนที่รวม cache และ retrieval pipeline อยู่ในเล่มด้านล่าง