จากถาม 1 ครั้ง เป็นแชตคุยต่อเนื่อง: เติม 3 อย่างให้สคริปต์ Claude จำบทสนทนาได้ ใน 30 นาที
ไฟล์ chat.py ของคุณเองที่คุยกับ Claude ต่อเนื่องหลาย turn ในเทอร์มินัล มีบทบาทที่คุณกำหนด จำเรื่องที่คุยไว้ และเข้าใจแล้วว่า system, user, assistant และ messages คืออะไร ซึ่งเป็นพื้นฐานที่ต้องมีก่อนไปถึง tool และ agent
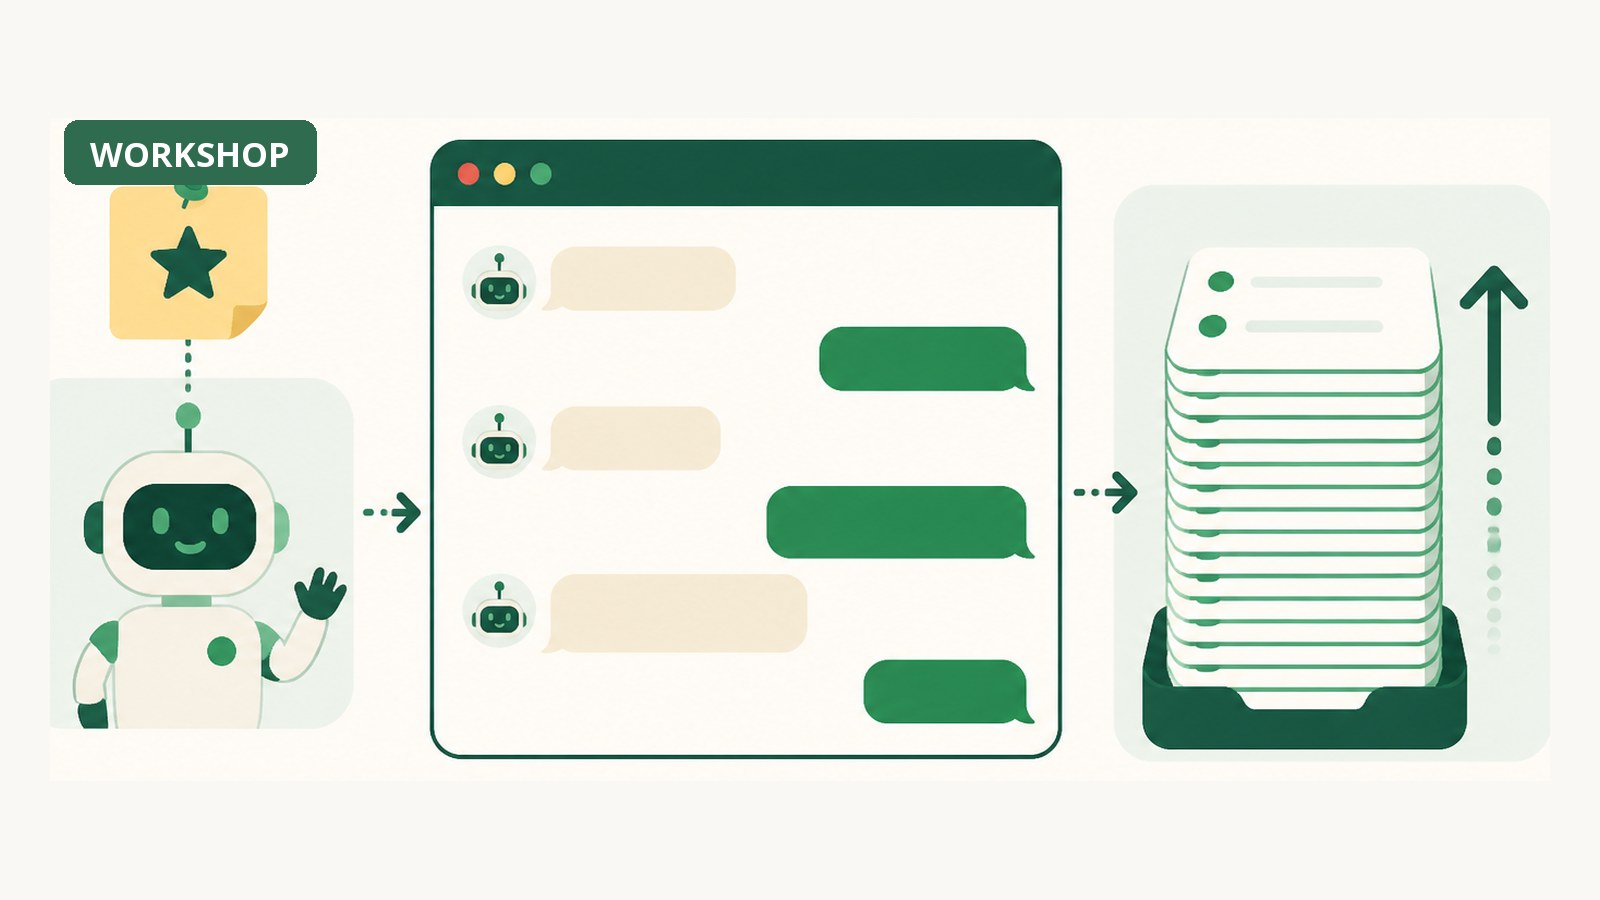
ใน workshop เรียก Claude API ครั้งแรก เราส่งคำถามไป 1 ครั้ง ได้คำตอบ 1 ครั้ง แล้วโปรแกรมจบ ซึ่งต่างจากประสบการณ์ในหน้าเว็บที่คุยกันไปมาได้เรื่อย ๆ วันนี้เราจะปิดช่องว่างนั้นด้วยการเติมของ 3 อย่างลงในสคริปต์เดิมทีละอย่าง แต่ละอย่างไม่กี่บรรทัด: บทบาท (system prompt), ความจำ (list ของ messages) และ loop ให้แชตได้ในเทอร์มินัล พร้อมเห็นกับตาว่า API “ไม่จำ” อะไรเลยจริง ๆ และความจำที่เราสร้างเองมีราคาที่ต้องจ่ายยังไง
ทั้งสามอย่างนี้คือคำศัพท์ที่จะโผล่ในทุกโค้ด AI ที่คุณเจอต่อจากนี้ (system, user, assistant, messages) และเป็นพื้นที่ต้องมีก่อนก้าวถัดไปคือให้ Claude เรียกฟังก์ชันของเราเอง ซึ่งเป็นประตูสู่ agent
ขั้นที่ 1: ให้บทบาทด้วย system prompt
เปิด first_claude.py จาก workshop ก่อน แล้วลองถามคำถามธรรมดา ๆ โดยยังไม่เติมอะไร เปลี่ยนแค่ข้อความใน content เป็น "list กับ tuple ต่างกันยังไง" และเพิ่ม max_tokens เป็น 800 แล้วรัน ผลจริงที่ได้ (ตัดมาบางส่วน):
# ความแตกต่างระหว่าง list กับ tuple ใน Python

## สรุปสั้น ๆ
| หัวข้อ | list | tuple |
|---|---|---|
| สัญลักษณ์ | `[1, 2, 3]` | `(1, 2, 3)` |
| แก้ไขได้ไหม | ได้ (mutable) | ไม่ได้ (immutable) |
...
## 3. ใช้เป็น key ของ dict / สมาชิกของ set ได้

```python
location = {(13.75, 100.50): "กรุงเทพ"}   # OK เพราะ tuple hashable
# location =

โทเคนขาเข้า 23 · ขาออก 800
ยาว เต็มไปด้วยศัพท์ (mutable, hashable) และขาดกลางคันที่ 800 โทเคนพอดี นี่คือพฤติกรรมเริ่มต้นเมื่อไม่มีใครบอกว่ามันเป็นใครและกำลังคุยกับใคร ทีนี้เติมบรรทัดเดียวคือ system= ก่อน messages สร้างไฟล์ใหม่ชื่อ chat_v1.py:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=800,
    system="คุณคือติวเตอร์สอน Python สำหรับมือใหม่ ตอบเป็นภาษาไทย ไม่เกิน 3 ประโยค ห้ามใช้ศัพท์เทคนิคโดยไม่อธิบาย",
    messages=[
        {"role": "user", "content": "list กับ tuple ต่างกันยังไง"}
    ],
)

for block in response.content:
    if block.type == "text":
        print(block.text)

print(f"\nโทเคนขาเข้า {response.usage.input_tokens} · ขาออก {response.usage.output_tokens}")
python3 chat_v1.pylist (ลิสต์) คือกล่องเก็บข้อมูลหลายค่าที่ "แก้ไขได้" เช่น เพิ่ม ลบ หรือเปลี่ยนค่าข้างในทีหลังได้
เขียนด้วยวงเล็บเหลี่ยม `[1, 2, 3]` ส่วน tuple (ทูเพิล) เก็บข้อมูลหลายค่าเหมือนกันแต่ "แก้ไขไม่ได้"
เมื่อสร้างเสร็จแล้ว เขียนด้วยวงเล็บโค้ง `(1, 2, 3)`
เลยนิยมใช้ list กับข้อมูลที่ต้องเปลี่ยนแปลงบ่อย เช่น รายชื่อนักเรียนที่อาจเพิ่มคนใหม่ และใช้ tuple
กับข้อมูลที่ไม่ควรเปลี่ยน เช่น พิกัดละติจูด-ลองจิจูด
โทเคนขาเข้า 116 · ขาออก 400คำถามเดิมเป๊ะ แต่คำตอบเปลี่ยนไปคนละแบบ system prompt คือคำสั่งถาวรที่บอกโมเดลว่า “คุณเป็นใคร คุยกับใคร ตอบแบบไหน” มันไม่ใช่ข้อความในบทสนทนา จึงไม่ต้องพิมพ์ซ้ำทุกคำถาม สังเกตตัวเลขด้วย: ขาเข้าโตจาก 23 เป็น 116 เพราะ system prompt นับเป็นโทเคนขาเข้าทุกครั้ง ส่วนขาออก 400 ทั้งที่ข้อความสั้นแค่นี้ เพราะรุ่นนี้ “คิดก่อนตอบ” และโทเคนที่ใช้คิดถูกนับรวม (นี่คือเหตุผลที่ max_tokens 300 ไม่พอ และเป็นเหตุผลที่โค้ดต้องวน loop เช็ก block.type == "text" แทนที่จะหยิบ content[0] ตรง ๆ เพราะ block แรกที่ส่งมาอาจเป็นก้อนความคิด ไม่ใช่ข้อความ)
คำตอบสั้นลงและเป็นภาษาติวเตอร์ตามที่สั่งใน system = ผ่าน ต่อไปทดสอบว่ามันจำอะไรได้ไหม
ขั้นที่ 2: พิสูจน์ว่า API ไม่จำอะไรเลย
ลองถามต่อเนื่องแบบที่เราทำในหน้าเว็บ คือคำถามที่ 2 อ้างถึงคำถามที่ 1 สร้าง chat_v2.py ที่ห่อการเรียกไว้ในฟังก์ชัน ask แล้วเรียก 2 ครั้ง:
import anthropic

client = anthropic.Anthropic()
SYSTEM = "คุณคือติวเตอร์สอน Python สำหรับมือใหม่ ตอบเป็นภาษาไทย ไม่เกิน 3 ประโยค ห้ามใช้ศัพท์เทคนิคโดยไม่อธิบาย"

def ask(text):
    response = client.messages.create(
        model="claude-opus-5", max_tokens=800, system=SYSTEM,
        messages=[{"role": "user", "content": text}],
    )
    return "".join(b.text for b in response.content if b.type == "text")

print("คำถามที่ 1:", ask("list กับ tuple ต่างกันยังไง"))
print()
print("คำถามที่ 2:", ask("แล้วอันไหนเร็วกว่ากัน"))
python3 chat_v2.pyคำถามที่ 1: list (ลิสต์) คือกล่องเก็บข้อมูลหลายค่าที่ "แก้ไขได้" เช่น เพิ่ม ลบ หรือเปลี่ยนค่าข้างในทีหลังได้
เขียนด้วยวงเล็บเหลี่ยม `[1, 2, 3]`
...
คำถามที่ 2: ขอโทษค่ะ/ครับ ผมยังไม่แน่ใจว่าคุณกำลังเปรียบเทียบอะไรอยู่ 🙂 ช่วยบอกหน่อยได้ไหมว่าอยากรู้ว่า
อะไรเร็วกว่าอะไร เช่น การวนลูปแบบ `for` กับ `while` หรือการเก็บข้อมูลแบบ list (รายการ) กับ set
(กลุ่มข้อมูลที่ไม่ซ้ำกัน) แล้วผมจะอธิบายให้ฟังพร้อมตัวอย่างเลยครับคำถามที่ 2 มันงงว่า “อันไหน” คืออะไร ทั้งที่เพิ่งตอบเรื่อง list กับ tuple ไปเมื่อวินาทีก่อน นี่ไม่ใช่บั๊ก API ไม่มีความจำระหว่างการเรียกแต่ละครั้ง ทุกครั้งที่เรียก messages.create โมเดลเห็นเฉพาะสิ่งที่อยู่ใน messages ของครั้งนั้น หน้าเว็บที่คุยต่อเนื่องได้ก็เพราะเบื้องหลังมันส่งประวัติทั้งหมดกลับไปให้ทุกครั้ง ซึ่งเป็นสิ่งที่เราจะทำเองในขั้นถัดไป
คำถามที่ 2 ได้คำตอบแบบ “ไม่รู้ว่าพูดถึงอะไร” = ผ่าน (ใช่ครับ ผ่านเพราะเห็นปัญหาแล้ว) ไปสร้างความจำกัน
ขั้นที่ 3: สร้างความจำด้วย list เดียว
ความจำของบทสนทนาคือ list ธรรมดาที่เก็บทุกข้อความ ทั้งของเรา (role: user) และของโมเดล (role: assistant) สลับกันไป แล้วส่ง list นั้นทั้งก้อนทุกครั้ง แก้ ask ใน chat_v2.py ให้เป็นแบบนี้ (ต่างจากเดิม 3 บรรทัด ดู comment):
import anthropic

client = anthropic.Anthropic()
SYSTEM = "คุณคือติวเตอร์สอน Python สำหรับมือใหม่ ตอบเป็นภาษาไทย ไม่เกิน 3 ประโยค ห้ามใช้ศัพท์เทคนิคโดยไม่อธิบาย"

messages = []  # ความจำของบทสนทนา: ทุกอย่างที่คุยกันอยู่ใน list นี้

def ask(text):
    messages.append({"role": "user", "content": text})          # 1) เก็บคำถามเรา
    response = client.messages.create(
        model="claude-opus-5", max_tokens=800, system=SYSTEM,
        messages=messages,                                       # 2) ส่งทั้ง list ไปทุกครั้ง
    )
    answer = "".join(b.text for b in response.content if b.type == "text")
    messages.append({"role": "assistant", "content": answer})   # 3) เก็บคำตอบของมันด้วย
    return answer

print("คำถามที่ 1:", ask("list กับ tuple ต่างกันยังไง"))
print()
print("คำถามที่ 2:", ask("แล้วอันไหนเร็วกว่ากัน"))
print()
print("ตอนนี้ messages มี", len(messages), "ข้อความ")
python3 chat_v2.pyคำถามที่ 1: list (ลิสต์) คือกล่องเก็บข้อมูลหลายค่าที่ "แก้ไขได้" ...
คำถามที่ 2: tuple เร็วกว่าเล็กน้อย เพราะ Python รู้ว่าค่าข้างในไม่เปลี่ยน เลยจัดการหน่วยความจำ
(ที่เก็บข้อมูลชั่วคราวในเครื่อง) ได้ง่ายกว่า และใช้พื้นที่น้อยกว่า list ด้วย แต่ความต่างนี้เล็กมากจนแทบ
ไม่รู้สึกในงานทั่วไป จะสังเกตได้ก็ต่อเมื่อข้อมูลเยอะมากหรือวนซ้ำหลายล้านรอบ ดังนั้นมือใหม่ควรเลือกจาก
"ต้องแก้ไขข้อมูลไหม" มากกว่าเลือกจากความเร็วนะครับ
ตอนนี้ messages มี 4 ข้อความคราวนี้มันรู้ว่า “อันไหน” คือ list กับ tuple เพราะคำถามและคำตอบรอบแรกถูกส่งไปด้วย ดู 4 ข้อความ ท้ายสุด: user, assistant, user, assistant สลับกัน นี่คือหน้าตาของ “บทสนทนา” ในสายตา API ทั้งหมด ไม่มีอะไรมากกว่านี้ ข้อที่มือใหม่พลาดบ่อยคือลืม append คำตอบ assistant แล้วส่งไปแต่คำถามของตัวเอง โมเดลจะเห็นแค่ครึ่งเดียวของบทสนทนาและตอบเพี้ยน
คำถามที่ 2 ตอบเรื่อง list กับ tuple ถูกต้อง และท้ายสุดขึ้น
4 ข้อความ= ผ่าน เหลือแค่ทำให้พิมพ์คุยได้เอง
ขั้นที่ 4: ครอบด้วย loop ให้แชตในเทอร์มินัล แล้วดูบิลโต
เอาความจำจากขั้นที่ 3 มาครอบด้วย while True และรับข้อความจากคีย์บอร์ดด้วย input() สร้างไฟล์ chat.py:
import anthropic

client = anthropic.Anthropic()
SYSTEM = "คุณคือติวเตอร์สอน Python สำหรับมือใหม่ ตอบเป็นภาษาไทย ไม่เกิน 3 ประโยค ห้ามใช้ศัพท์เทคนิคโดยไม่อธิบาย"

messages = []

while True:
    text = input("คุณ: ")
    if text.strip() in ("จบ", "exit"):
        break
    messages.append({"role": "user", "content": text})
    response = client.messages.create(
        model="claude-opus-5", max_tokens=800, system=SYSTEM, messages=messages,
    )
    answer = "".join(b.text for b in response.content if b.type == "text")
    messages.append({"role": "assistant", "content": answer})
    print("Claude:", answer)
    print(f"   (ขาเข้า {response.usage.input_tokens} · ขาออก {response.usage.output_tokens} · ความจำ {len(messages)} ข้อความ)\n")
python3 chat.pyแล้วคุย 3 คำถามที่อ้างถึงกันเป็นทอด ๆ พิมพ์ จบ เพื่อออก บทสนทนาจริงที่ได้ตอนเขียนชิ้นนี้:
คุณ: ขอตัวอย่างโค้ดสร้าง list ชื่อผลไม้ 3 อย่าง
Claude: ```python
fruits = ["แอปเปิ้ล", "กล้วย", "ส้ม"]
print(fruits)
```

บรรทัดแรกคือการสร้าง "list" (ลิสต์) คือกล่องเก็บข้อมูลหลายชิ้นไว้ด้วยกัน โดยใส่ข้อมูลไว้ในวงเล็บเหลี่ยม
`[ ]` และคั่นแต่ละชิ้นด้วยเครื่องหมายจุลภาค `,` ...
   (ขาเข้า 139 · ขาออก 322 · ความจำ 2 ข้อความ)

คุณ: เพิ่มอีก 1 อย่างทำยังไง
Claude: ```python
fruits.append("มะม่วง")
print(fruits)
```

ใช้คำสั่ง `.append()` (แอปเพนด์ แปลว่า "ต่อท้าย") เพื่อเพิ่มข้อมูลชิ้นใหม่เข้าไปที่ท้ายลิสต์ ...
ผลลัพธ์จะได้ `['แอปเปิ้ล', 'กล้วย', 'ส้ม', 'มะม่วง']`
   (ขาเข้า 442 · ขาออก 239 · ความจำ 4 ข้อความ)

คุณ: แล้วถ้าอยากรู้ว่ามีกี่อย่าง
Claude: ```python
print(len(fruits))
```

ใช้คำสั่ง `len()` (ย่อจาก length แปลว่า "ความยาว") เพื่อนับว่าในลิสต์มีข้อมูลกี่ชิ้น ... กรณีนี้จะได้
ผลลัพธ์เป็น `4` เพราะมีผลไม้ 4 อย่างแล้ว
   (ขาเข้า 676 · ขาออก 201 · ความจำ 6 ข้อความ)

คุณ: จบ
มันจำได้ทั้งชื่อตัวแปร fruits และรู้ว่าตอนนี้มีผลไม้ 4 อย่าง (นับมะม่วงที่เพิ่มในคำถามก่อน) โดยเราไม่ต้องพิมพ์ย้ำ แต่ดูตัวเลขในวงเล็บให้ดี: ขาเข้าโตจาก 139 → 442 → 676 ทั้งที่แต่ละคำถามของเราสั้นพอ ๆ กัน เพราะทุก turn เราส่งประวัติทั้งหมดกลับไปใหม่ ความจำแบบนี้จึงมีราคา ยิ่งคุยนานยิ่งจ่ายต่อ turn มากขึ้นและช้าลง นี่คือปัญหาแรกที่ทุกคนที่ทำแชตบอตจริงต้องแก้ (ตัดประวัติเก่า สรุปย่อ หรือใช้ cache ซึ่งเป็นเรื่องของเล่มท้ายบทความ) ลองเล่นต่อได้เลย: เปลี่ยน SYSTEM เป็นบทบาทอื่น หรือคุยยาว ๆ แล้วดูว่าขาเข้าไปถึงเท่าไหร่
แชตต่อเนื่องได้ 3 turn โดยมันอ้างเรื่องเก่าถูก และเห็นเลขขาเข้าโตขึ้นทุก turn = ผ่าน จบ workshop
ไปต่อจากตรงนี้
วันนี้สคริปต์ 15 บรรทัดกลายเป็นแชตบอตที่มีบทบาท มีความจำ และคุยต่อเนื่องได้ ที่สำคัญกว่าโค้ดคือคำ 4 คำที่ตอนนี้คุณเห็นภาพแล้ว: system คือคำสั่งถาวร, user กับ assistant คือสองฝั่งของบทสนทนา, และ messages คือ list ที่เป็นความจำทั้งหมด ซึ่งโมเดลเห็นแค่สิ่งที่อยู่ในนั้น
ก้าวถัดไปคือให้ Claude ทำมากกว่าตอบ: ประกาศ “ฟังก์ชันของเรา” ให้มันรู้จัก แล้วให้มันขอเรียกใช้เมื่อต้องการข้อมูลจริง (อ่านไฟล์ ดูเวลา ค้นฐานข้อมูล) โดยเราเป็นคนรันแล้วส่งผลกลับเข้า messages เดิมนี่แหละ เมื่อทำตรงนั้นได้ ระยะทางจากแชตบอตไปถึง agent ที่ลงมือทำงานเองจะเหลือแค่ loop เดียว ส่วนใครอยากทำแชตบอตให้พร้อมใช้จริงก่อน (streaming, กัน error, คุมต้นทุนความจำ) เล่มด้านล่างพาไปครบ