เลือกโมเดลยังไงให้คุ้มเงิน: Haiku / Sol / Flash ต่างกันตรงไหน
ช่วงปลายกันยายนถึงต้นตุลาคม 2026 ราคาโมเดลเปลี่ยนเร็วจนตามแทบไม่ทัน OpenAI เปิดตัว GPT-6.1 Sol ที่ราคาเหลือหนึ่งในห้าของรุ่นท็อป Anthropic หั่นราคา Claude Haiku 5.5 ลงเหลือ 10 เซนต์ต่อล้าน token ส่วน Google ก็ขาย Gemini Flash รุ่นใหม่ในราคาโปรโมชันถึงสิ้นปี คำถามที่ตามมาคือ แล้วงานของเราควรใช้ตัวไหน คำตอบสั้นที่สุดคือ เลือกตัวที่ถูกที่สุด “ที่ยังทำงานนั้นผ่าน” แล้ววัดเป็นราคาต่องาน ไม่ใช่ราคาต่อ token
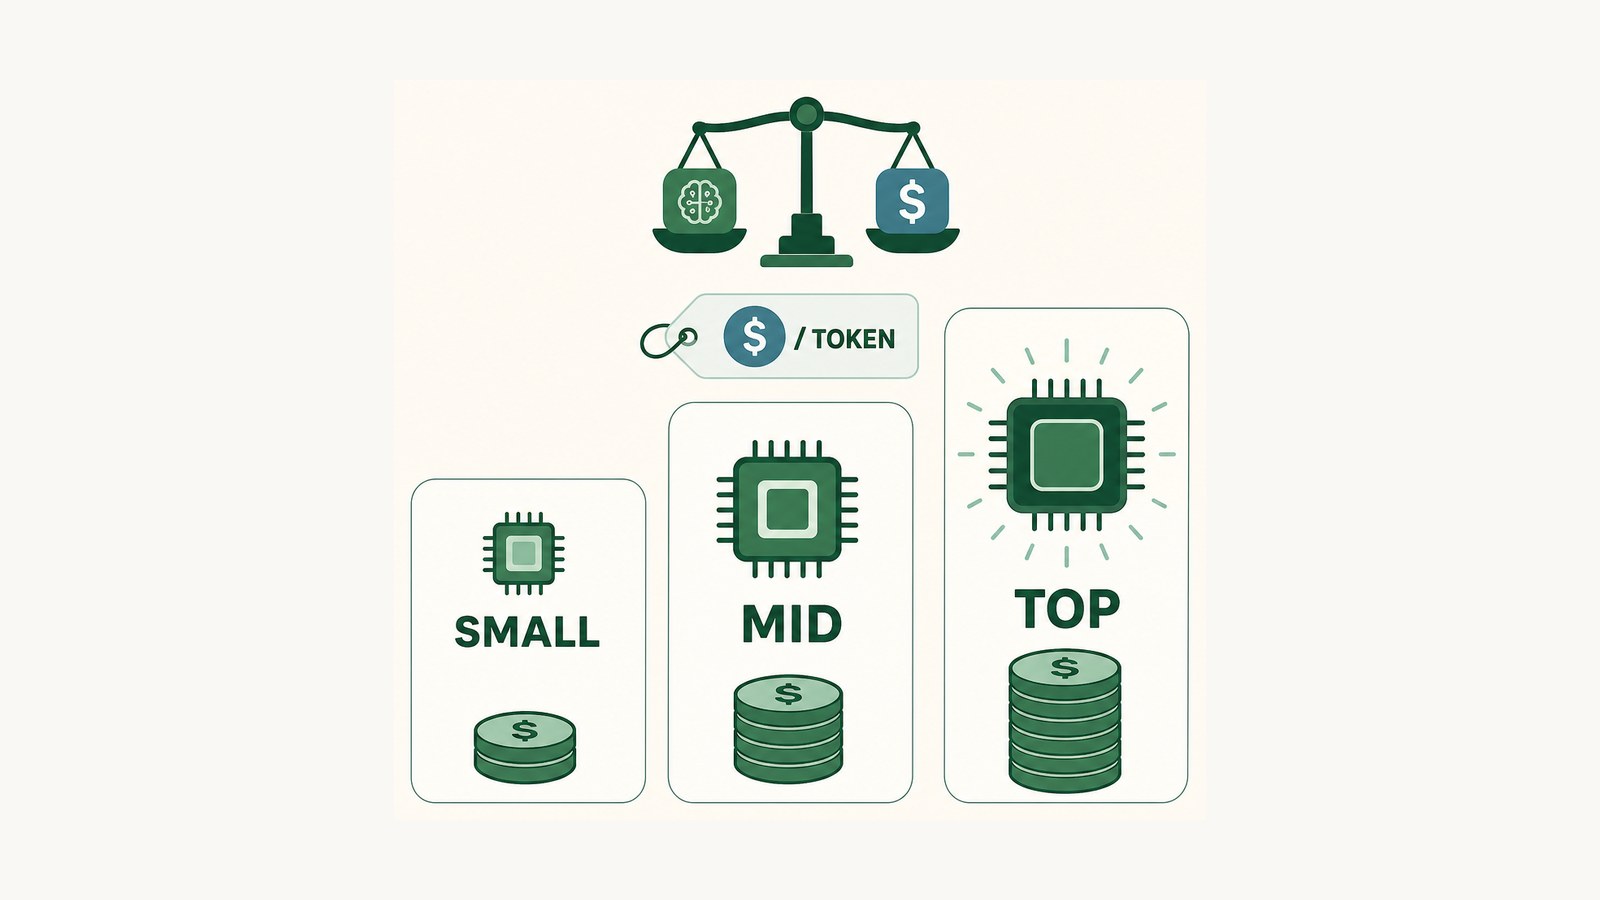
สรุปสั้น ๆ: โมเดลในตลาดตอนนี้แบ่งได้ 3 ชั้น คือตัวเล็ก (Haiku 5.5, GPT-6 Luna, Flash-Lite) ตัวกลาง (Sonnet 5.5, GPT-6.1 Sol, Gemini Flash) และตัวท็อป (Opus 5.5, Fable 5.1, GPT-6 Astra) ราคาต่อ token ของตัวถูกสุดกับตัวแพงสุดต่างกันได้ถึง 100 เท่า วิธีเลือกที่คุ้มคือเริ่มจากตัวเล็ก เทสกับงานจริง แล้วขยับขึ้นเฉพาะงานที่ตัวเล็กทำไม่ผ่าน และต้องระวังกับดัก 3 อย่าง: เรทที่กระโดดเมื่อ prompt ยาว, ราคาโปรโมชันที่หมดอายุ, และโมเดลที่ใช้ token มากกว่าที่คิด
ทำไมราคาต่อ token ถึงหลอกตา
คำตอบตรง ๆ: บิลที่คุณจ่ายจริงคือ ราคาต่อ token คูณจำนวน token ที่งานนั้นใช้ และจำนวน token ไม่ได้เท่ากันทุกโมเดล โมเดลที่ป้ายราคาถูกกว่าครึ่งหนึ่งอาจจบงานแพงกว่าได้ ถ้ามันต้องคิดยาวกว่า ตอบยาวกว่า หรือต้องให้ลองใหม่บ่อยกว่า
มีตัวแปรซ่อนอยู่อย่างน้อย 4 ตัวที่ป้ายราคาไม่บอก
- tokenizer (ตัวหั่นข้อความเป็น token) — แต่ละยี่ห้อหั่นต่างกัน ข้อความไทยเดียวกันอาจนับได้ไม่เท่ากันหลายสิบเปอร์เซ็นต์ และภาษาไทยมักกิน token มากกว่าภาษาอังกฤษที่ความหมายเท่ากันราว 1.5 ถึง 2 เท่า
- thinking token (token ที่โมเดลใช้คิดก่อนตอบ) — คิดเงินเป็น output ทั้งหมด และ output แพงกว่า input ตั้งแต่ 5 เท่าขึ้นไปแทบทุกยี่ห้อ
- ระดับ effort — โมเดลรุ่นใหม่ตั้งได้ว่าจะให้คิดหนักแค่ไหน ตั้งสูงได้คุณภาพเพิ่มแต่ token พุ่งตาม
- อัตราลองใหม่ — งานที่ตัวถูกทำพลาด 1 ใน 5 ครั้งแล้วต้องรันซ้ำ ต้นทุนจริงจะบวกเพิ่มขึ้นไปอีก
ตัวอย่างที่เห็นชัดคือ Haiku 5.5 เอง Anthropic ยอมรับว่ารุ่นนี้ใช้ tokenizer ตัวใหม่ที่นับ token ได้มากขึ้นเล็กน้อยสำหรับงานเท่าเดิม ดังนั้นตัวเลขประหยัดที่บริษัทประเมินจึงอยู่ราว 75% เมื่อเทียบกับ Haiku 4.5 ไม่ใช่ 90% อย่างที่ป้ายราคาชวนให้คิด อีกจุดคือ Haiku 5.5 ตั้งค่า effort เริ่มต้นไว้ที่ระดับกลาง คะแนน Terminal-Bench ราว 39% ที่โชว์ในประกาศนั้นวัดที่ effort สูงสุด ถ้าใช้ค่าเริ่มต้นจะได้ราว 20% นี่คือเหตุผลที่ต้องเทสกับงานของตัวเองเสมอ
ราคาต่อ token บอกแค่ว่าวัตถุดิบแพงแค่ไหน ราคาต่องานต่างหากที่บอกว่าอาหารจานนั้นแพงแค่ไหน
โมเดล 3 ชั้น: แผนที่ราคาเดือนตุลาคม 2026
คำตอบตรง ๆ: ทั้งสามค่ายวางสินค้าเป็นขั้นบันไดคล้ายกัน ราคาด้านล่างเป็นราคามาตรฐานต่อ 1 ล้าน token (input / output) จากหน้าราคาทางการ ณ 13 ตุลาคม 2026 ราคาเปลี่ยนได้เสมอ ให้เปิดหน้าราคาของแต่ละค่ายเช็กอีกรอบก่อนตั้งงบ
ชั้นเล็ก: งานซ้ำ ปริมาณมาก ไม่ต้องคิดลึก
- Claude Haiku 5.5 — $0.10 / $0.50 เมื่อ prompt ไม่เกิน 100K token แต่ถ้าเกินจะเป็น $0.50 / $2.50 รองรับ context 1M token
- GPT-6 Luna — $0.10 / $0.50 เท่ากับ Haiku 5.5 และขึ้นเรทเมื่อ input เกิน 272K token
- Gemini 3.5 Flash-Lite — $0.30 / $2.50 และ Gemini 3.1 Flash-Lite ที่ $0.25 / $1.50
เหมาะกับงานคัดแยกข้อความ ดึงข้อมูลจากเอกสารเป็น JSON สรุปสั้น ตอบคำถามจากคลังความรู้ที่ดึงมาให้แล้ว และเป็นด่านแรกที่ตัดสินใจว่างานไหนควรส่งต่อให้ตัวใหญ่
ชั้นกลาง: ตัวหลักของงานส่วนใหญ่
- Gemini 3.8 Flash — $0.75 / $3.75 แต่เป็นราคาโปรโมชันถึง 31 ธันวาคม 2026 ตั้งแต่ 1 มกราคม 2027 จะขึ้นเป็น $1.50 / $7.50
- Claude Sonnet 5.5 — $2 / $10
- GPT-6.1 Sol — $2 / $10 เปิดตัวที่งาน DevDay 29 กันยายน 2026 และขึ้นเรทเมื่อ prompt เกิน 272K token
จุดน่าสังเกตคือ Sonnet 5.5 กับ Sol ราคาเท่ากันเป๊ะ ทำให้การตัดสินใจระหว่างสองตัวนี้ขึ้นกับว่าตัวไหนทำงานของคุณได้ดีกว่า ไม่ใช่ตัวไหนถูกกว่า ชั้นนี้เหมาะกับงานเขียนโค้ด งาน agent ที่ต้องเรียกเครื่องมือหลายขั้น และงานเอกสารที่ต้องใช้เหตุผล
ชั้นท็อป: เก็บไว้ใช้กับงานที่ผิดไม่ได้
- Claude Opus 5.5 — $4 / $20
- GPT-6 Astra — $10 / $50
- Claude Fable 5.1 — $10 / $50
ชั้นนี้คุ้มกับงานวิเคราะห์ที่ซับซ้อนมาก งานที่ความผิดพลาดหนึ่งครั้งมีต้นทุนสูงกว่าค่าโมเดลทั้งเดือน หรือใช้เป็นกรรมการตรวจคำตอบของตัวเล็ก ถ้าอยากเห็นว่าโมเดลระดับนี้เก่งขึ้นแค่ไหนในงานเขียนโค้ด ดู ข่าว Claude Fable 5.1 ประกอบ
ลองคิดบิลจริง: ระบบสรุปเอกสาร 1,000 ฉบับต่อวัน
คำตอบตรง ๆ: งานเดียวกันบนโมเดลต่างชั้นมีค่าใช้จ่ายต่อเดือนต่างกันได้ตั้งแต่หลักสิบไปจนถึงหลักร้อยดอลลาร์ ลองตั้งโจทย์ง่าย ๆ คือระบบสรุปเอกสารภาษาไทย 1,000 ฉบับต่อวัน แต่ละครั้งส่ง input ราว 3,050 token (คำสั่ง + เนื้อเอกสาร) และได้คำตอบกลับราว 500 token ทั้งเดือน 30 วันจะเท่ากับ input 91.5 ล้าน token และ output 15 ล้าน token
- Haiku 5.5 — ราว $17 ต่อเดือน (input $9.15 + output $7.50)
- Gemini 3.5 Flash-Lite — ราว $65 ต่อเดือน
- Gemini 3.8 Flash — ราว $125 ต่อเดือนช่วงโปรโมชัน และราว $250 หลังขึ้นราคาปีหน้า
- Haiku 4.5 (รุ่นก่อน) — ราว $167 ต่อเดือน
- Sonnet 5.5 หรือ Sol — ราว $333 ต่อเดือน
- Opus 5.5 — ราว $666 ต่อเดือน
ตัวเลขชุดนี้คิดจากจำนวน token สมมติที่เท่ากันทุกตัว ในความจริงแต่ละยี่ห้อจะนับข้อความไทยชุดเดียวกันได้ไม่เท่ากัน และบางตัวตอบยาวกว่ากัน ช่องว่างจึงอาจแคบหรือกว้างกว่านี้ แต่ภาพรวมชัดพอ ถ้า Haiku 5.5 สรุปงานนี้ได้ผ่านเกณฑ์ การยืนใช้ Sonnet ต่อเพราะความเคยชินเท่ากับจ่ายแพงขึ้นเกือบ 20 เท่าโดยไม่ได้อะไรเพิ่ม
ก่อนเลือกโมเดล ให้คูณเลขให้ได้ก่อนว่างานหนึ่งเดือนจะใช้ token เท่าไร ตัวเลขนี้ตัวเดียวช่วยตัดตัวเลือกที่ไม่คุ้มออกไปได้ครึ่งหนึ่ง
กับดัก 3 อย่างที่ทำให้บิลบานปลาย
คำตอบตรง ๆ: ส่วนใหญ่ไม่ได้มาจากการเลือกโมเดลผิดตั้งแต่แรก แต่มาจากเงื่อนไขราคาที่อ่านไม่ครบ
1. เรทที่กระโดดเมื่อ prompt ยาว
Haiku 5.5 ถูกมากก็จริง แต่พอ prompt เกิน 100K token ราคาต่อ token จะขึ้นเป็น 5 เท่าทันที งานที่เสี่ยงที่สุดคือ agent ที่คุยยาวหลายรอบ เพราะทุกรอบส่งประวัติการคุยทั้งหมดกลับไปใหม่ ช่วงแรกอาจอยู่ใต้เส้นตลอด แล้วข้ามเส้นเงียบ ๆ ตอนงานเริ่มซับซ้อน Sol กับ Luna ก็มีเส้นแบบเดียวกันที่ 272K token วิธีป้องกันคือตัดหรือสรุปประวัติเก่าทิ้งเป็นระยะ และดึงเฉพาะเอกสารที่เกี่ยวข้องด้วย RAG แทนการยัดทั้งก้อน
2. ราคาโปรโมชันที่มีวันหมดอายุ
Gemini 3.8 Flash ที่ $0.75 / $3.75 เป็นราคาชั่วคราวถึงสิ้นปี 2026 ถ้าคุณตั้งงบปีหน้าจากราคานี้ บิลเดือนมกราคมจะเป็นสองเท่าทันที ให้คิดงบจากราคาหลังโปรเสมอ แล้วถือส่วนต่างช่วงโปรเป็นกำไรแถม
3. ลืมส่วนลดที่ได้ฟรี
ทุกค่ายมีสองตัวช่วยที่ลดบิลได้มากกว่าการเปลี่ยนโมเดล ตัวแรกคือ prompt caching (เก็บส่วนของ prompt ที่ซ้ำทุกครั้งไว้ไม่ต้องคิดใหม่) อ่านจาก cache ถูกกว่าราคาปกติ 90% ขึ้นไป ตัวที่สองคือ batch (ส่งงานเป็นชุดแล้วรอผลภายหลัง) ลดราคาลงครึ่งหนึ่ง งานที่ไม่ต้องตอบทันที เช่น สรุปเอกสารตอนกลางคืน ควรวิ่งผ่าน batch แทบทั้งหมด
วิธีเลือกที่ใช้ได้กับทุกรุ่นในอนาคต
คำตอบตรง ๆ: ชื่อรุ่นจะเปลี่ยนทุกไม่กี่เดือน แต่ขั้นตอนเลือกยังใช้ได้เหมือนเดิม
- เตรียมชุดทดสอบจากงานจริง 20 ถึง 50 ข้อ — ใช้ตัวอย่างจากงานของคุณเอง ภาษาไทยจริง พร้อมเกณฑ์ว่าคำตอบแบบไหนถือว่าผ่าน
- เริ่มจากตัวถูกสุดก่อนเสมอ — รันชุดทดสอบกับโมเดลชั้นเล็ก ดูว่าผ่านกี่ข้อ ถ้าผ่านพอ หยุดตรงนั้น
- วัดราคาต่องานจากของจริง — ดูจำนวน token ที่ใช้จริงจาก response แต่ละครั้ง รวมถึงจำนวนครั้งที่ต้องลองใหม่ แล้วหารเป็นต้นทุนต่อหนึ่งงาน
- ขยับขึ้นเฉพาะงานที่ตก — ระบบที่คุ้มที่สุดมักใช้ตัวเล็กเป็นด่านแรก แล้วส่งต่อเฉพาะงานยากให้ตัวกลางหรือตัวท็อป แนวคิดนี้อยู่ในหัวใจของการ ออกแบบระบบ AI ให้ใช้งานได้จริง
- เทสซ้ำทุกครั้งที่มีรุ่นใหม่ — ชุดทดสอบเดิมใช้ได้ตลอด รุ่นใหม่ออกเมื่อไรก็รันซ้ำได้ภายในชั่วโมงเดียว
อีกทางเลือกที่มักถูกลืมคือไม่จ่ายรายครั้งเลย งานปริมาณมากที่ข้อมูลออกนอกองค์กรไม่ได้ อาจคุ้มกว่าถ้าใช้ Local AI ที่รันในเครื่องเอง ต้นทุนจะย้ายจากค่า token ไปเป็นค่าเครื่องและค่าคนดูแลแทน
มองไปข้างหน้า: เมื่อตัวเล็กถูกเกือบเป็นศูนย์
ภาพที่เห็นชัดในปี 2026 คือโมเดลชั้นเล็กถูกลงเร็วกว่าชั้นอื่น ตอนนี้ Haiku 5.5 กับ Luna อยู่ที่ราคาเดียวกันแล้ว และคะแนนที่ค่ายต่าง ๆ รายงานเองก็บอกว่าตัวเล็กรุ่นใหม่ทำงานบางประเภทได้ใกล้ตัวกลางรุ่นก่อน แต่ยังต้องรอผลทดสอบอิสระมายืนยัน สิ่งที่จะเปลี่ยนไปจึงไม่ใช่คำถามว่าใช้ AI ไหวไหม แต่เป็นคำถามว่าออกแบบงานให้ตัวเล็กทำได้มากแค่ไหน
ทีมที่ได้เปรียบในปีหน้าจึงไม่ใช่ทีมที่ใช้โมเดลแพงที่สุด แต่เป็นทีมที่มีชุดทดสอบของตัวเอง รู้ต้นทุนต่องานเป็นตัวเลข และสลับโมเดลได้ภายในวันเดียวเมื่อราคาเปลี่ยน เพราะในตลาดที่ราคาขยับทุกเดือน ความสามารถในการเปลี่ยนตัวเลือกได้เร็วมีค่ามากกว่าการเลือกตัวที่ดีที่สุดในวันนี้